
ユーザーファーストのAIがまた一歩前進:Leoがエンドツーエンド暗号化、Oblivious HTTP、検証可能な機密コンピューティングに対応
Braveブラウザに組み込まれたAIアシスタントである Brave AI チャット(Leo)は、このたび、自分で検証できる業界最高水準のプライバシー を提供するようになりました。
LeoでのオープンウェイトのGLMモデルとのやり取りは、エンドツーエンド暗号化とハードウェアによる機密コンピューティングで保護されます。Braveブラウザは、プロンプトをお使いのデバイスから送信する前に、デバイス上で暗号化します。復号してプロンプトを機密LLM推論にかけられるのは、アテステーション(構成証明)を受けたTrusted Execution Environment(TEE)だけです。
仕組みの概要は次のとおりです。
- プライバシーの約束だけでなく、暗号による証明を。 プロンプトがブラウザから送信される前に、TEEはハードウェアが署名したアテステーションを提示しなければなりません。これを検証することで、セキュアなハードウェアが本物であること、そしてTEE内で動作するモデルと公開監査可能なコードが改ざんされていないことを確認します。
- デバイスから出る前に、その場で暗号化。 Braveブラウザは、プロンプトがデバイスから出る前にOblivious HTTP(OHTTP)で暗号化します。これにより、アテステーション済みのTEEだけが復号できます。
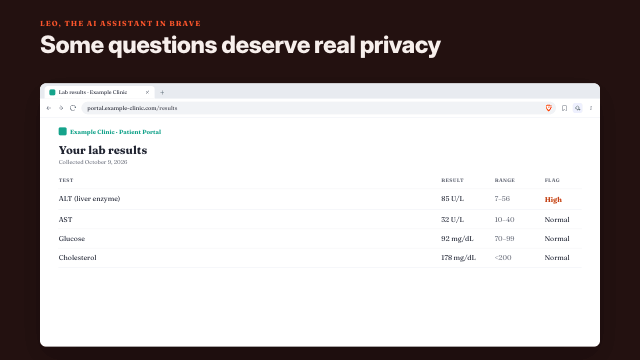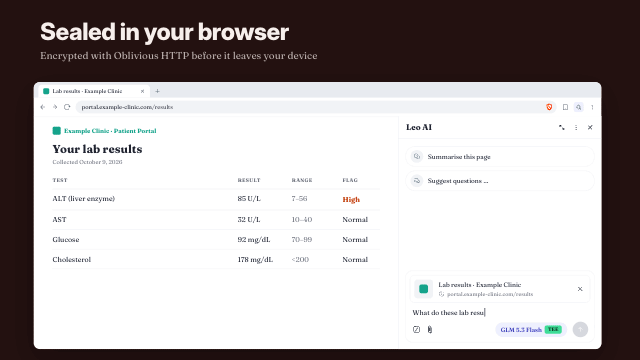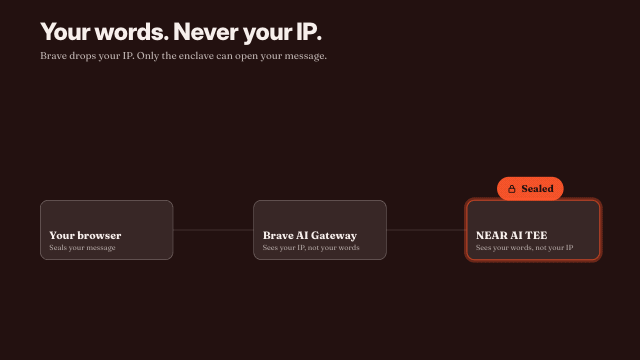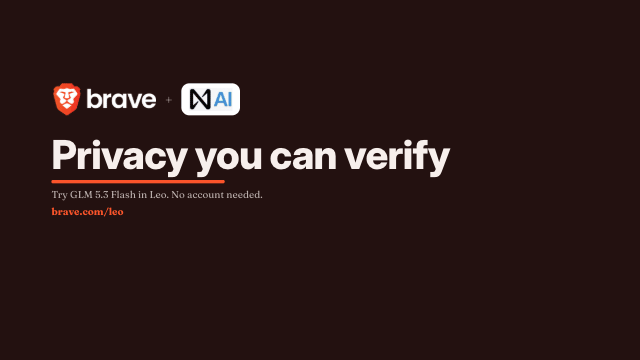
- IPアドレスは非公開のまま。 ブラウザは暗号化したプロンプトを、オープンソースのBrave AI Gateway経由で送信します。AIプロバイダーであるNEAR AIには、お客様のIPアドレスが伝わりません。
- ハードウェアで守られた機密LLM推論。 GLM 5.3 Flashモデルは、NEAR AIが運用する、Nvidia基盤の封印されたハードウェアエンクレーブ内で動作します。ハードウェアによる分離により、プロンプトと応答は、BraveやNEAR AIを含むインフラ運用者からも保護されます。
本機能は、Brave 安定版、Beta版、Nightly版で本日から利用できます。これは、2025年11月に発表した「検証可能なプライバシーと透明性:Brave AIプライバシーの新境地」に続く、ユーザーファーストのAIに向けた新たな一歩です。
最もプライベートな質問が、AIチャットボットでどう漏洩されたか
午後11時。医療ポータルサイトに検査結果が届き、数値のひとつが赤字で表示されていました。担当医の診療所が開くのは月曜日です。そこで、ページの横にいるAIアシスタントに、その数値の意味を尋ねます。街の反対側では、督促状を開いたまま、自分の権利をAIに説明してもらっている人がいます。画面に離婚の和解案を表示して、これから署名する内容をAIに確認する人もいます。マネージャーは受信箱にある機密の人員削減計画の要約をAIに頼み、同じ会社の社員は人事規定を読みながら、彼女を訴えられるかどうかを尋ねています。全員が、会話も、横に開いているページも、外に漏れないと思い込んでいます。
今や人々はAIとこうした会話を交わしています。共有したページと合わせると、検索クエリよりはるかに多くのことが分かってしまいます。OpenAIのCEOであるサム・アルトマン氏は、人々がChatGPTを「セラピストやライフコーチ」として使っていると語っています。2026年のKFF調査では、米国の成人の3人に1人が健康情報を得るためにAIチャットボットを利用したと答えました。そのうち41%は、検査結果や医師のメモなどの個人の医療情報をアップロードしたことがあります。OpenAI自身も、自殺の計画をうかがわせる会話をしているChatGPTユーザーが週に100万人を超えると報告しています。職場でも、2025年のLayerXのレポートによれば、AIツールを使う従業員の77%がデータをペーストしています。そのうち5分の1以上には、個人情報やクレジットカード情報が含まれていました。
ほとんどのAIサービスでは、こうした会話も一緒に共有したページも、すべて他社のサーバーに保存されます。AI企業やその背後にいる企業が、中身を読める状態です。いったんサーバーに渡ってしまうと、次の5つの問題が起こりえます。
- 新たなモデルの学習に使われる。 2025年のスタンフォード大学の研究によると、米国の主要AI開発企業6社は、デフォルトでユーザーのチャットをモデルの学習に使っているとみられます。なかには、チャットを無期限に保持する企業もあります。
- 裁判所に提出される。 ニューヨーク・タイムズの著作権訴訟では、連邦判事がOpenAIに対し、削除されたものも含めてChatGPTのユーザーの会話を保存するよう命じました。さらに2025年11月には、匿名化された2,000万件のチャットログの提出も命じています。OpenAIは、「この規模での個人情報の包括的な提出」を裁判所が命じた例は知らないとしています。サム・アルトマン氏も数か月前に、訴訟や命令でデータを求められれば「提出を求められる可能性がある」と警告していました。
- バグやオープンなデータベースから漏れる。 2023年3月には、ChatGPTのバグにより、一部のユーザーに他人の会話のタイトルが表示されました。2026年1月には、人気アプリ「Chat & Ask AI」がデータベースを公開状態のままにしており、2,500万人超のユーザーによる約3億件のメッセージが流出しました。そこには、きわめてセンシティブな質問も含まれていました。
- 誰でも見つけられる形で公開される。 2025年には、共有リンクがユーザーの知らないうちにインデックスされ、37万件以上のGrokの会話がGoogleで検索できる状態になりました。共有されたChatGPTの会話も数千件が検索結果に表示され、OpenAIが該当機能を取り下げる事態になりました。Meta AIのDiscoverフィードには、公開したつもりのなかった人たちによる医療や法律の質問があふれました。自分の意思で共有された会話でも、ChatGPT、Copilot、Geminiの会話10万342件を調べた2026年の研究では、約8%にセンシティブな個人データが含まれていました。
- 別のモデルが回答する。 プロバイダーは、選択されたモデルをこっそり別のモデルに差し替えることができます。NeurIPS 2025の研究では、こうした差し替えは回答だけでは確実に見抜けないことが分かりました。
エンドツーエンドで暗号化されたBrave AIは、こうした事態がお客様の会話に起こらないように設計されています。BraveとNEAR AIは、読み取り可能な形でチャットのコピーを保持しません。そのため、学習に使われることも、提出を求められることも、漏えいすることもありません。履歴はお使いのデバイスに残り、モデルの開発元がお客様の言葉を目にすることもありません。さらに、アテステーションによって、どのモデルが回答しているのかを確認できます。これらは誰かの善意に頼ったものではありません。仕組みとして強制されており、お客様自身で確かめることもできます。その方法はこの記事の後半で説明します。
AIのプライバシーリスクは、Braveが長年Web上でユーザーのプライバシーを守るために戦ってきたリスクと似てきています。プロバイダーが会話を保持し、その扱いを第三者が検証できなければ、新しい用途があっという間に、しかも気づかれないうちに生まれかねません。チャットが、より広範なプロファイルの一部にされてしまうこともあります。2026年9月、セキュリティ研究者のBuchodi氏が報告したところによると、OpenAIの広告システムはChatGPTアカウントに紐づくCookieを設定します。このCookieは、広告主のWebサイトから、そこで閲覧したページの情報とともにOpenAIへ送り返されます。OpenAIのCookieポリシーでは、このCookieは「マーケティング」ではなく「アナリティクス」に分類されています。そのため、マーケティングCookieを無効にしている人にも設定されます。Buchodi氏によるAndroid版Chromeでのテストでは、この仕組みによって、医療や借金に関するページを含む、それらのサイトでの閲覧行動がChatGPTアカウントに、ひいては本人に結びつけられる可能性がありました。Braveのユーザーは保護されています。この追跡が依存するクロスサイトCookieを、Braveブラウザがデフォルトでブロックするからです。検証できなければ、自分のデータがどう扱われているかを知るきっかけは、外部の研究者による発見だけになってしまいます。
オープン性、透明性、検証可能なプライバシー:AI以前から続くBraveの原則を、Brave AIに
1883年、暗号学者のオーギュスト・ケルクホフスは、セキュリティはシステムの設計を秘密にすることに頼るべきではないと主張しました。優れたシステムは、仕組みがすべて公開されていても安全であり続けます。それから1世紀後の1983年、Unixの共同開発者であるケン・トンプソンは、チューリング賞の受賞講演「Reflections on Trusting Trust」で、公開されたソースコードでさえ人をだましうることを示しました。侵害されたコンパイラは、どのソースコードにも現れないバックドアを埋め込めるのです。彼の結論は厳しいものでした。「自分で完全に作ったのではないコードは、信頼できない」。自分のコードをすべて自力で書く人はいません。ここから私たちが得た教訓は、オープン性は重要だが、それだけでは足りないということです。実際に動いているものを検証することも欠かせません。
この考え方は、今のAIブームよりずっと前から、Braveのあり方を形づくってきました。2014年、のちにブライアン R. ボンディとともにBraveを共同創業するブレンダン・アイクは、Trust but Verifyを共同執筆しました。この文書は、ブラウザベンダーが強制されて、監視用のコードをひそかに組み込む可能性があると警告しています。トンプソンの攻撃を引き合いに出し、独立した検証を求めました。研究者が公開ソースコードからソフトウェアを再ビルドし、ユーザーが実際に受け取ったものと一致するかを確認するというものです。Braveはこの考え方を受け継いでいます。ブラウザは公開の場で開発され、コードはオープンソースです。
AIによって、問われるものはさらに大きくなりました。前のセクションで見たとおり、人々は最も個人的な情報をAIアシスタントに打ち明けています。しかも、誰がそれを読めるのか、どう処理されるのか、そもそもどのモデルが応答しているのかさえ、ほとんど見えません。プライバシーが、プロバイダーの「信じてください」のひと言に行き着いてしまうことは少なくありません。これが「プライバシーの香水」です。誰にも確かめられないシステムに、安心を誘う言葉を吹きかけているだけです。
Braveは、プライバシーは検証できるものであるべきだと考えています。Brave AIは、この原則を次のように実践しています。
- オープン性: プロトコル、リレー、検証ツール、モデルのウェイト、そしてTEE内で動作するNEAR AIのコードは、すべて公開されています。ケルクホフスの原則のとおり、秘密にするのは鍵だけです。しかも、お客様の会話を復号できる鍵であるTEEの秘密鍵は、TEEの外に出ることはありません。
- 透明性: この記事とその裏付けとなるコードを見れば、データがどこへ送られ、誰が何を見られるのかを正確に把握できます。さらにアテステーションによって、回答がお客様の選んだモデルから返ってきたものであり、より安価な代替モデルによるものではないことも確認できます。
- 検証可能なプライバシー: アテステーションは、TEE内で実際にどのコードが動いているかを証明します。さらに、当社の検証オラクルがNEAR AIのコードを公開ソースから再ビルドし、一致することを確認します。これは、トンプソンが示した問題の解決に向けた現実的な一歩です。この確認を終えて初めて、ブラウザは会話をエンドツーエンドで暗号化するための鍵を受け取ります。こうして、会話を復号できるのはTEEだけになります。
オープンウェイトモデルを「有望」と語る企業は多いが、Braveはすでに本番運用している
Braveは、オープンウェイトモデルの可能性を、毎日使われるプロダクトとして形にしてきました。 Leoは2023年秋、オープンウェイトのLlama 2を無料のデフォルトモデルとして公開しました。その数か月後にはMixtralに切り替えています。現在LeoではQwen、DeepSeek、Kimi、Mistral、NvidiaのNemotronなどのオープンウェイトモデルを、Braveがホストして提供しています。オープンだからといって品質を犠牲にしているわけではありません。2026年6月の最新の比較評価では、オープンウェイトのQwen3とBraveのLLM Context APIを搭載したAsk Braveが、評価対象としたすべてのAI回答エンジンを上回りました。そこにはGrok、Google AI Mode、ChatGPT、Perplexityも含まれます。
そして今回、オープンウェイトAIを「性能」から「検証可能なプライバシー」へと一歩前進させます。 GLM 5.3 Flashは、Z.aiが2026年8月に寛容なMITライセンスのもとでウェイトを公開したモデルで、エンドツーエンド暗号化されたBrave AIを支えています。ウェイトが公開されているため、独立した運用者であるNEAR AIが、GLM 5.3 Flashをアテステーション済みのハードウェア内だけでホストできます。開発元のZ.aiが、お客様の会話を目にすることはありません。また、ウェイトが公開されているので、TEEがアテステーションで示すモデルは、誰でもダウンロードして中身を調べ、ベンチマークで試せるものです。クローズドなモデルもTEEで動かせますが、それは開発元の管理下に限られ、ウェイトは第三者が調べられないままです。
とはいえ、オープンウェイトだけでは十分ではありません。 ウェイトを見ても分かるのは、モデルが何であるかまでで、どのように作られたかは分かりません。ウェイトへの悪意ある改変も排除できません。研究者らは、モデルのウェイトにバックドアを仕込めることを示しています。しかも場合によっては、検出が原理的に不可能であることが証明されています。だからこそ、オープン性は学習にまで広げる必要があります。Nvidiaは現在、Nemotronモデルを、ウェイトだけでなく学習データの多くと学習レシピも付けて公開しています。ただし、オープンな学習が意味を持つのは、それを検証できる場合に限られます。現状では再現性が課題です。公開されたレシピがあっても、それが実際に使われたものだと信じるしかありません。検証可能なオープン学習は、このギャップを埋めます。Gensynのopen-1bは、学習のすべてのステップを再現・検証できるようにしています。
Brave Researchもこの方向へ進んでいます。当社のConfidential-DPproofは、データを秘匿したままでも、学習を検証できることを示しています。 ただし、検証済みのモデルを使っても、それだけでAIがプライベートになるわけではありません。モデルを動かす側は、依然として会話を読めてしまうからです。そこでBrave AIは、オープンウェイト、オープンなコード、検証可能なハードウェアを組み合わせます。これにより、モデルの開発元、運用会社、そして当社を信頼することに頼る度合いを大きく減らせます。これらが合わさることで、AIに長らく欠けていたもの、つまり「信じなくても成り立つプライバシー」に一歩近づきます。
検証可能なプライバシーと透明性に向けた、Brave AIの最初の一歩(2025年11月)
2025年11月、Braveは最初の一歩として、NEAR AIのNvidia基盤のTEEを通じて、Brave AIに機密コンピューティングを導入しました。原則はシンプルです。ユーザーが期待するAIモデルと、プライベートな会話をしていることを、ただ信じるのではなく、自分で検証できなければなりません。
最初のリリースでは、モデルはTEE内で動作し、ユーザーのリクエストは、当社既存のプライバシー保護のもとでBraveのサーバーを経由していました。通信は暗号化され、ログには記録されず、応答の生成後に破棄されます。ただし、これらの保護は当社のポリシーに基づくもので、暗号技術による保証ではありませんでした。また、BraveのサーバーがTEEの証明を確認し、ユーザーには緑色のラベルを表示していました。つまり、その確認もBraveを信頼することが前提でした。
当社は、より広く展開する前に、2つのことを約束しました。1つは、Brave AI Gateway(Brave AIチャットのバックエンド)を含め、パイプラインのすべての段階をオープンソース化すること。もう1つは、検証をユーザーの手元に近づけることです。今回のリリースでは、すべての段階のコードを公開し、検証が暗号技術にもとづいて実際に機能するようにしました。さらにエンドツーエンド暗号化を導入し、検証ツールを運用するBraveでさえ、送信内容を読めないようにしています。
私たちが先駆けとなれたこと、そしてOpenAIをはじめ他社も後に続き始めていることを、うれしく思います。OpenAIは先月Private Intelligenceを発表しましたが、プライベート推論の提供はこれからです。Brave AIの業界最高水準のアプローチは、すでに実現しています。すべてのBraveユーザーが本日から利用でき、誰でも中身を調べられるオープンウェイトモデルを使い、すべての段階のコードを公開しています。
次のステップへ:検証してから信頼する、エンドツーエンド暗号化チャット
パイプラインをオープンソース化し、アテステーションを暗号化の前提条件にしました。Braveブラウザは、TEEの検証に合格した後に初めて提供される鍵に対して、プロンプトを暗号化します。Braveは暗号化されたメッセージを中身を読むことなく中継し、TEEは保護された環境の内部で復号して処理します。
NEAR AIのTEEで動作するオープンウェイトのGLM 5.3 Flashを使ったBrave AIチャットは、エンドツーエンドで暗号化されるようになりました。TEEの検証、メッセージの暗号化、中継を行うコードは、オープンソースです。
- お使いのマシンを出る前に封印。 ブラウザは、各プロンプトと、Leoと共有したページを、IETF標準のOblivious HTTPで暗号化します。暗号化に使う鍵は、ハードウェアで分離されたNvidia基盤のTEEの内部にしか存在しません。Brave、NEAR AI、クラウドホストのいずれも、中身を読むことはできません。
- 個々のユーザーとは結びつかない。 Brave AI Gatewayは、暗号化されたままのメッセージを中継する前にIPアドレスを取り除きます。TEEのプロバイダーは、誰が質問しているのかを知ることがありません。
- 検証済みのTEEだけが、お客様の言葉を受け取る。 ブラウザが鍵を受け取る前に、Braveのオープンソースの検証ツールがTEEのアテステーションを確認します。確認するのは、承認済みのビルドであることと、TEEの内部で署名された鍵であることです。確認に失敗した場合、Braveは鍵を渡さず、メッセージも中継しません。
これらによって、会話は保存時、送信時、処理時のいずれも保護されます。会話を読めるのは、お客様のデバイスと、TEE内のアテステーション済みコードだけです。中継役が読むことはできません。Brave AI GatewayはTEEを確認し、封印されたメッセージを中継します。メッセージを中継するためIPアドレスは目にしますが、お客様の言葉を目にすることはありません。TEEもBrave Searchも、IPアドレスを知ることはありません。
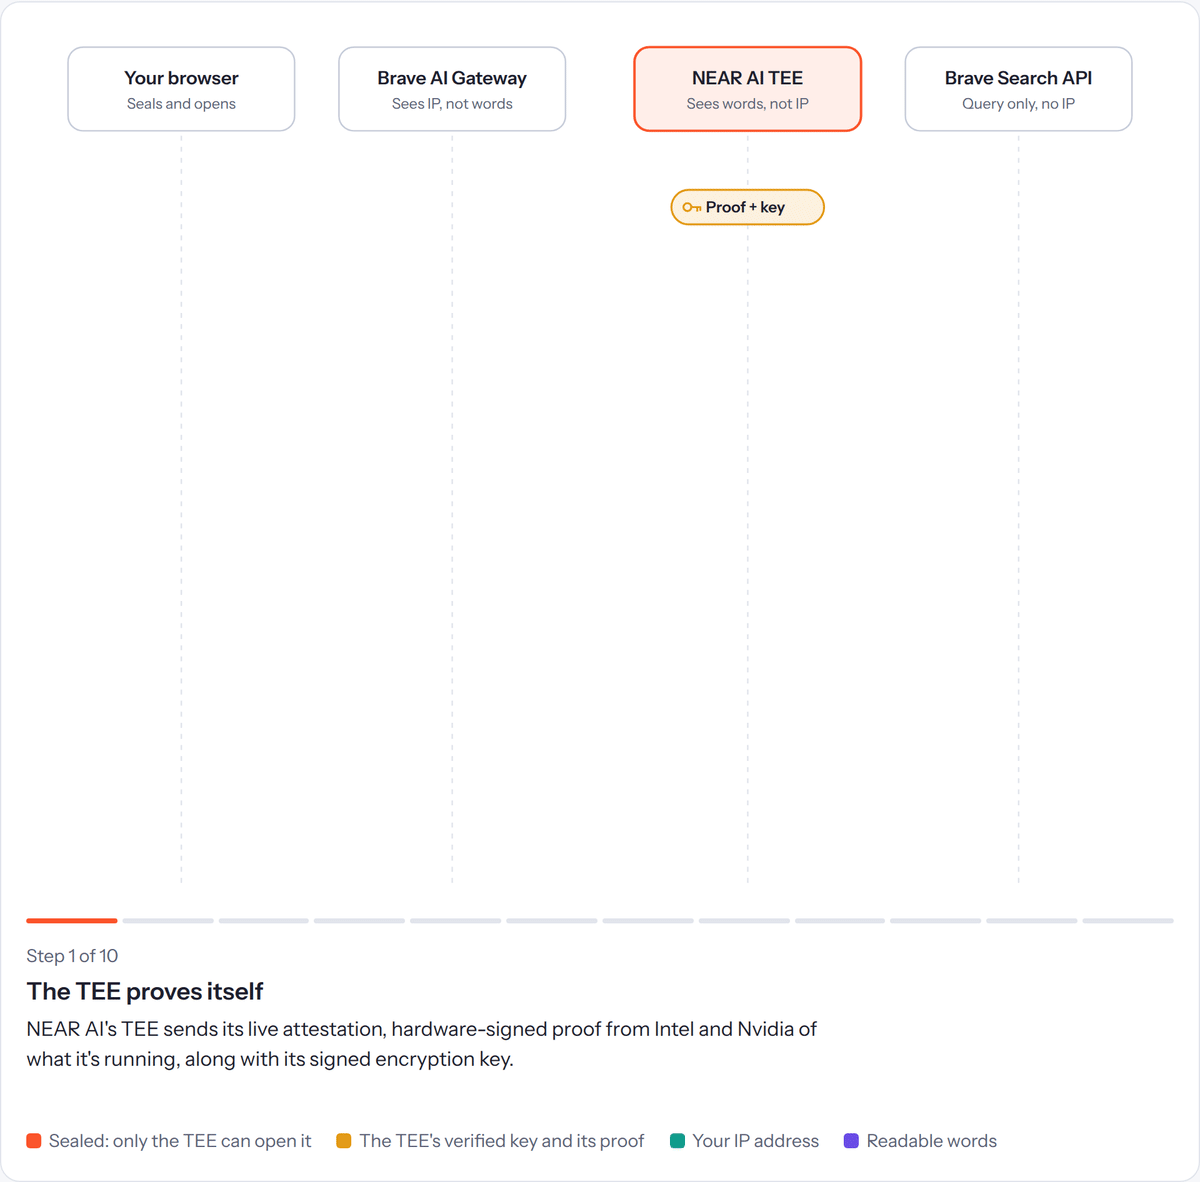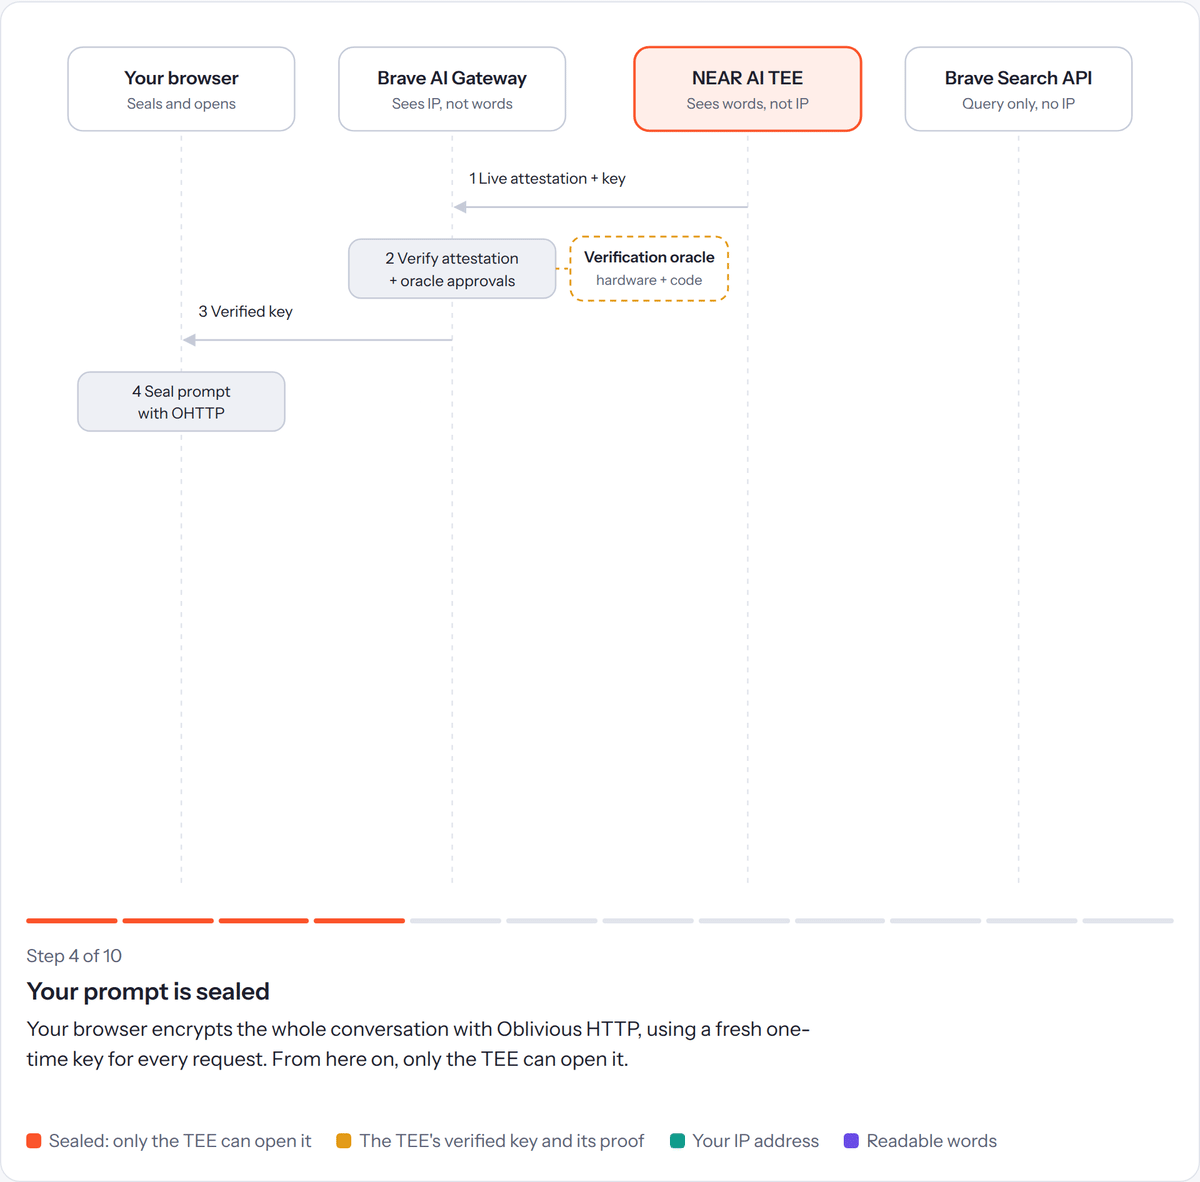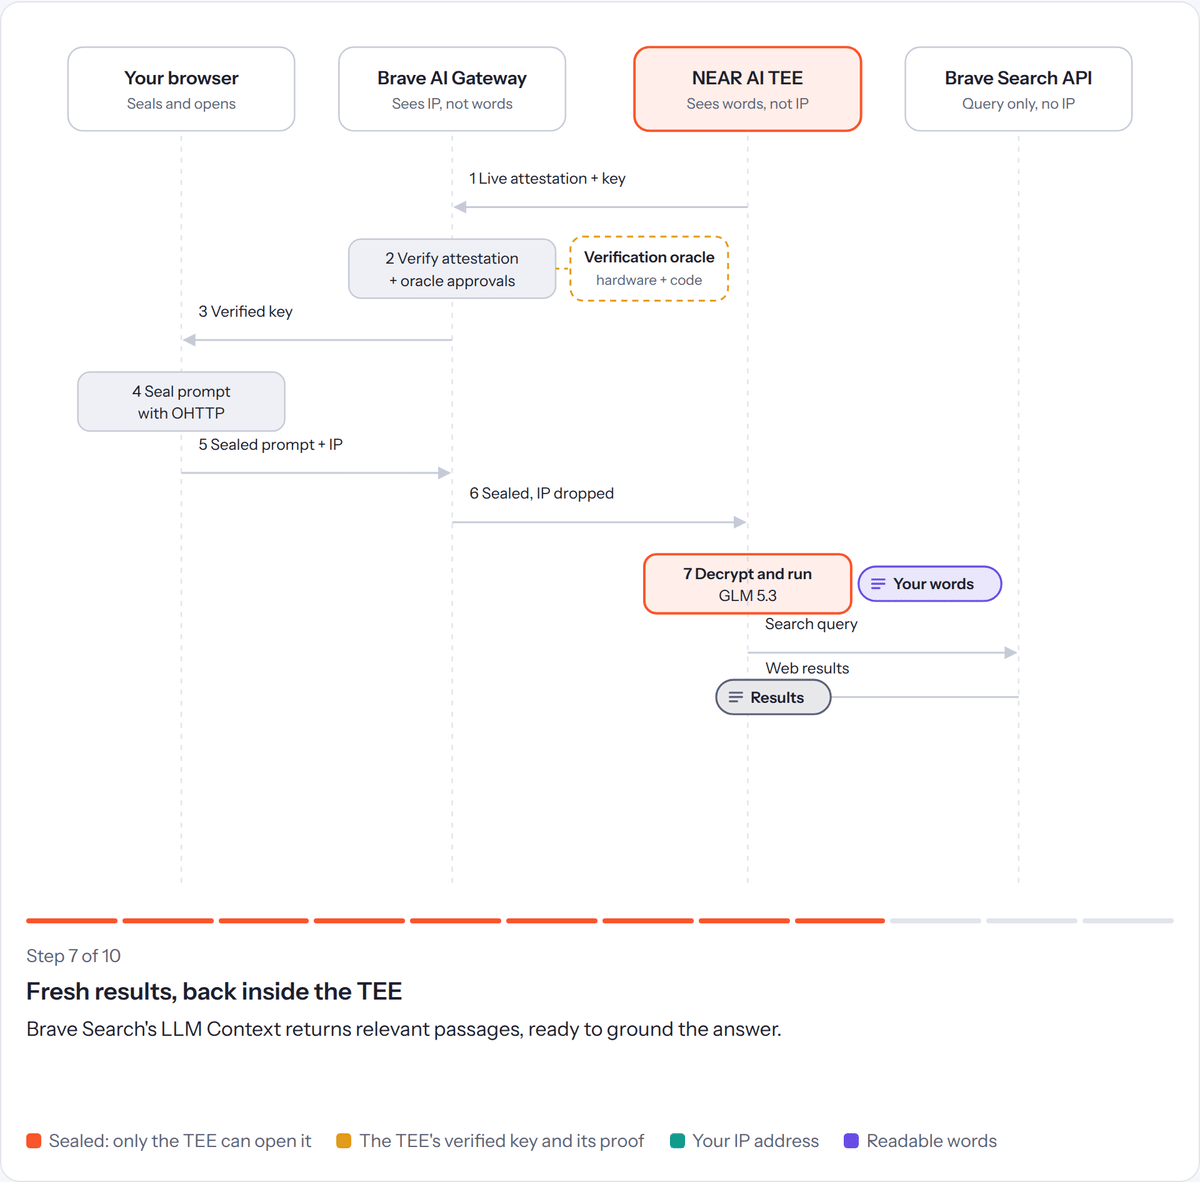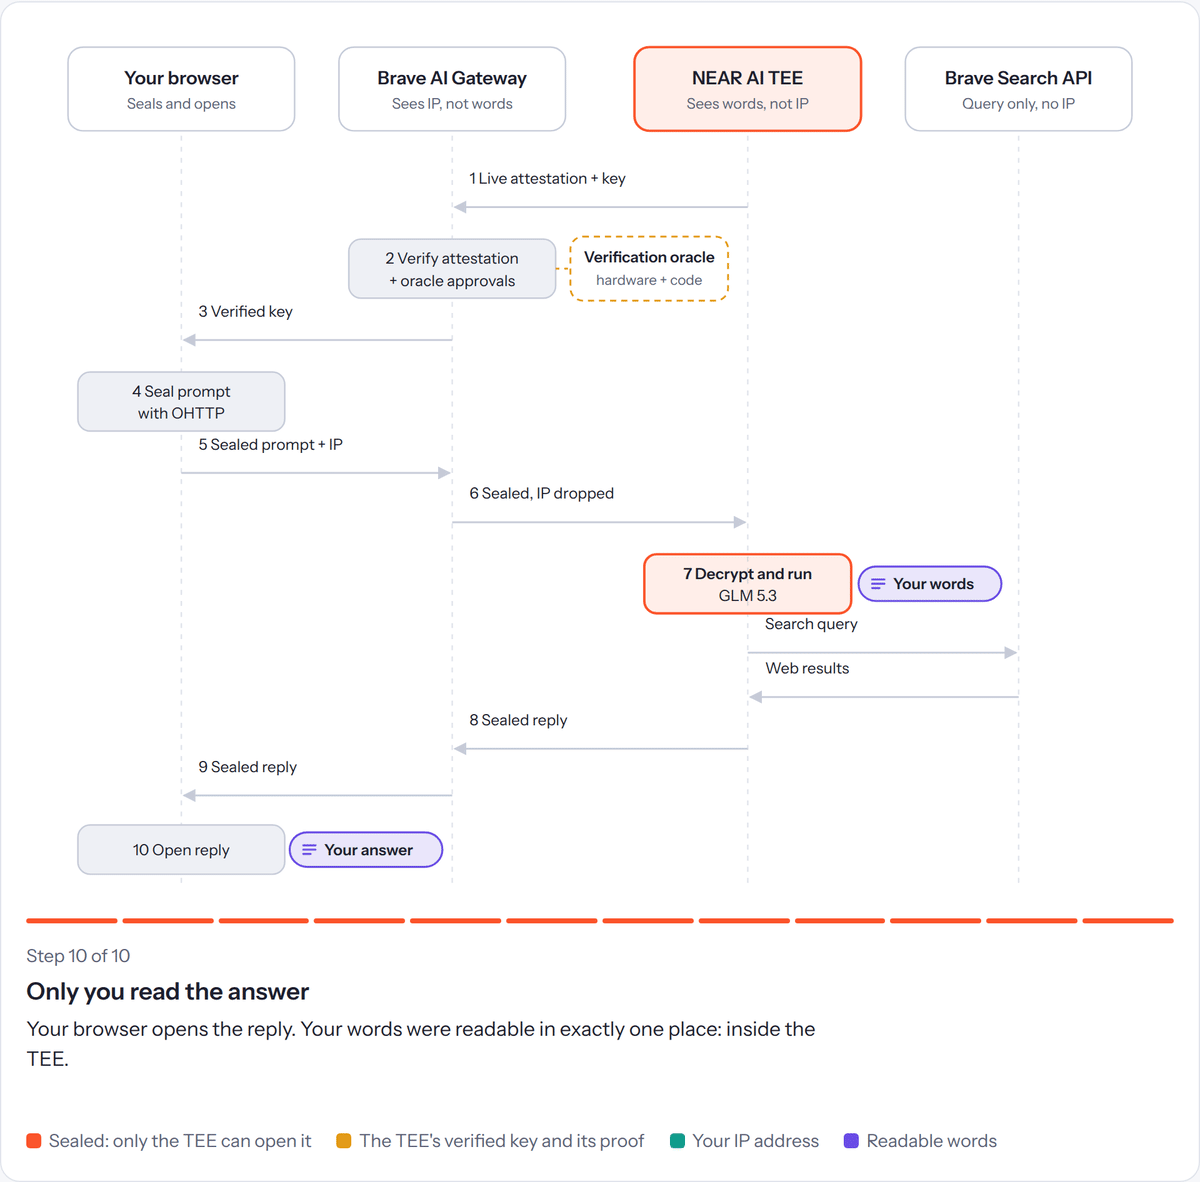
以下、各ステップを順に説明します。
ステップ1:ブラウザが鍵を受け取る前に、TEEが自らの正体を証明する
ブラウザが何かを暗号化するには、まずTEEの公開鍵が必要です。この鍵は、TEEが自らの正体を証明した後にしか渡されません。
まず、当社の検証オラクルが、NEAR AIのTEEのデプロイをすべて監査します。Braveが承認するのは、その後です。
- 本物のハードウェア。 TEEのハードウェアアテステーション(TDXクォート)に付されたIntelの署名を検証し、CPUエンクレーブが本物のIntel TDXハードウェアであることを証明します。GPUのアテステーションはNvidiaのRemote Attestation Serviceで検証し、モデルが本物でアテステーション済みのNvidia GPU上で動作していることを証明します。
- 監査済みのコードを、ソースから再ビルド。 NEARが作成したソフトウェアイメージにはすべて、署名付きのビルド来歴(プロベナンス)が必要です。これは公開の透明性ログに記録され、Braveがレビューしたソースコードのコミットを正確に指し示します。そのうえでオラクルがそのソースからイメージを再ビルドし、実際に動作しているものと一致することを確認します。これがトンプソンの教訓の実践です。検証するのはソースだけでなく、実際に動いているものです。BraveがNEARのコードの更新を承認する前には、変更内容をレビューします。その中には、プロンプトが漏れる新たな経路が生まれていないかを確かめる自動のプライバシーチェックも含まれます。
- お客様が選んだモデル。 アテステーションされたモデルが、リクエストされたモデルであることを確認します。さらに、ハードウェアでアテステーションされたデプロイログを使い、どのモデルイメージが動いているかを正確に証明します。サードパーティ製のモデルランタイムはソースから再ビルドしないため、代わりにこのログで固定(ピン留め)します。
- エンクレーブに紐づく鍵。 署名鍵は、検証済みのハードウェアアテステーションに組み込まれている場合にのみ記録します。
すべてのチェックに合格しなければなりません。オラクルが各ソフトウェアイメージと署名鍵の承認を記録するのは、そのときだけです。
次に、オープンソースのBrave AI Gatewayが、お客様が選択したモデルのTEEについて最新のアテステーションを取得し、これらの承認と照合します。TEEの暗号化鍵には、承認済みの署名鍵による有効なデジタル署名が必要です。すべてのチェックに合格した鍵だけがブラウザに送られます。ゲートウェイは、メッセージを中継するたびに再チェックを行い、その際に使う検証結果は1時間以内のものに限られます。検証に失敗すると、Braveはその変化を検知し、鍵を渡さず、メッセージも中継しません。
現在、ブラウザはこのチェックをゲートウェイに頼っています。次の段階では、ブラウザがオラクルの承認済みリスト(署名付き)と各鍵を自分で照合するようになります。その先では、ブラウザがハードウェアアテステーションを直接検証します。そうなれば、TEEを保証してもらうためにBraveのサーバーを信頼する必要はなくなります。
ステップ2:ブラウザ内でOblivious HTTPにより封印する
検証済みの鍵を手にしたブラウザは、IETF標準のOblivious HTTP(OHTTP)を使ってメッセージを封印します。ここではChromiumに組み込まれたOHTTPのサポートを利用しています。OHTTPの内部では、ハイブリッド公開鍵暗号(HPKE、RFC 9180)が使われています。
- リクエストごとに、ブラウザが使い捨て(一時的)のX25519鍵ペアを新たに生成します。
- この一時鍵とTEEの公開鍵の間で楕円曲線ディフィー・ヘルマン(ECDH)鍵交換を行い、共有秘密を生成します。
- HKDF-SHA256が、共有秘密を共通鍵に変換します。
- 会話を含むチャットリクエスト全体を、AES-128-GCMで暗号化します。これは改ざんも検出できる認証付き暗号です。
- ブラウザは、一時公開鍵と暗号文を送信します。対応する秘密鍵を持つTEEだけが、共有秘密を再計算して復号できます。
応答も封印されて返ってきます。TEEは、少しずつストリーミングする回答を、同じ鍵交換から導いた鍵で暗号化します。そのため、読めるのはお客様のブラウザだけです。
やり取りのたびに新しいリクエストとなります。ブラウザは使い捨ての鍵を新たに生成し、会話履歴の全体を暗号化し直します。
ステップ3:IPアドレスを質問内容から切り離す
暗号化は発言内容を隠しますが、リクエストを受け取った側には、それがどこから届いたかが分かってしまいます。OHTTPはこの問題を、リレーとゲートウェイという2つの当事者に役割を分けることで解決します。どちらの当事者も、IPアドレスと発言内容の両方を知ることはありません。
名前に反して、Brave AI GatewayはOHTTPのリレーの役割を担っています。お客様のメッセージを復号するゲートウェイは、NEAR AIのTEEの内部にあります。OHTTPのプライバシー保証は、形式的に解析されています。
ブラウザは、封印したメッセージをリレーとして動作するBrave AI Gatewayに送ります。BraveはIPアドレスを確認できますが、メッセージはTEE宛てに暗号化されているため読めません。Braveは、IPアドレスを破棄したうえで、暗号文をBrave自身のアカウントでNEAR AIのTEE(ゲートウェイ)に転送します。そのためNEAR AIから見ると、すべてのリクエストがBraveから届いたように見えます。TEEはメッセージを復号して応答しますが、IPアドレスを知ることはありません。
| IPアドレスを把握 | 質問内容を把握 | |
|---|---|---|
| Brave AI Gateway(リレー) | はい | いいえ |
| NEAR AIのゲートウェイTEE(cloud-api、Intel TDX) | いいえ | はい(TEEの内部でのみ復号) |
| NEAR AIの推論TEE(Intel TDX + Nvidia GPU) | いいえ | はい(TEEの内部) |
これは、Leoが従来から備えている保護の上に成り立っています。アカウントやログインは不要で、IPアドレスのログも記録せず、Premiumのサブスクリプションはリンク不可能なトークンで検証します。そのため、支払い情報を会話と結びつけることはできません。
ステップ4:TEE内での機密LLM推論(プライベートなWeb検索を含む)
TEEの内部では、メッセージはハードウェアで保護されたメモリ上で復号され、処理されます。Intel TDXのCPUでは暗号化されたメモリ、Nvidiaの機密コンピューティング対応GPUではファイアウォールで保護されたメモリが使われ、両者の間の転送も暗号化されます。ステップ1でオラクルが検証したのは、この環境です。Intelのアテステーションは、CPUエンクレーブが本物であることを証明します。Nvidiaのアテステーションは、GPUが本物でアテステーション済みであることを証明します。さらにリプロデューサブルビルド(再現可能なビルド)によって、内部で動作するNEAR AIのコードが、Braveが監査したコードそのものであることが証明されます。GLM 5.3 Flashはこの環境で動作し、ホストマシン、NEAR AI、クラウド事業者は、その内部を見ることができません。
調べものができなければ、プライベートなAIアシスタントもあまり役に立ちません。そこでモデルは、TEEの内部から直接、検索ツールを呼び出せるようになりました。この呼び出しには、Brave Search APIのLLM Contextエンドポイントが応答します。LLM Contextは、リンクの一覧ではなく、クエリとの関連度で順位付けしたWebの文章をモデルに渡します。前述のAsk Braveの結果を支えているのも、これと同じグラウンディングの仕組みです。
何を検索するかはTEEの内部でモデルが判断するため、そのために会話がTEEの外で復号されることはありません。GLM 5.3 Flashが生成した検索クエリは、ブラウザではなくTEEから送信されます。そのため、お客様のIPアドレスとは結びつきません。さらにこれらのクエリは、Brave Search APIのゼロデータ保持オプションの対象で、Brave独自のインデックスから結果が返されます。
保存時、送信時、処理時のすべてで保護されます
データには、保存時(保管されている状態)、送信時(マシン間を移動している状態)、処理時(処理されている状態)の3つの状態があります。Brave AIは、この3つすべてを保護します。
| 状態 | 保護の仕組み | 会話を読める人 |
|---|---|---|
| 送信時 | ブラウザ内でTEEが保持する鍵に対して暗号化し、さらにオブリビアスなリレーを経由 | ブラウザとTEEの間には、Braveを含め誰も読めない |
| 処理時 | ハードウェアで分離され暗号化されたCPUメモリ(Intel TDX)と、ファイアウォールで保護されたGPUメモリ(Nvidia) | TEE内のアテステーション済みコードのみ |
| 保存時 | BraveもNEAR AIも会話を保存しない。履歴はお使いのデバイスに残る | ユーザーのみ(お使いのデバイス上) |
暗号による検証の土台となる、公開され監査可能なコード
アテステーションが証明するのは、特定のコードが動作しているという事実です。誰でもそのコードを読めて初めて、この証明に意味が生まれます。そのため、パイプラインのすべての段階のコードを公開しています。Braveのコンポーネントはオープンソースで、TEE内で動作するコードはNEAR AIが公開しています。
- クライアント: 検証済みの鍵を取得し、OHTTPでメッセージを封印し、応答を開封するBraveブラウザのコードです。oblivious_http_api_client.ccとoblivious_http_config_manager.ccが該当します。
- リレーと検証ツール: TEEのアテステーションを検証し、封印されたメッセージを中継するBrave AI Gatewayのコードです。ohttp.pyとnear.pyが該当します。
- 検証オラクル: TEEのビルドと署名鍵を検証し、合格したものを記録するシステムです。near-verifierが該当します。
- 推論: TEE内で動作するNEAR AIのコードです。inference-proxy(モデルの前段に置かれ、アテステーションを生成します)、compose-manager(モデルを起動し、どのモデルが動いているかを記録します)、cloud-api(NEAR AIのAPIゲートウェイ)が該当します。
どの検証の連鎖も、最後は信頼するしかないものにたどり着きます。当社の場合は次のとおりです。IntelとNvidia(ハードウェアとアテステーションサービス)、dstack(エンクレーブのOS)、Sigstore(ビルド記録)、GitHub(ソースコード)、Hugging Face(モデルのウェイト)、そしてパブリックDNS(証明書のチェック)です。
ぜひお試しください。そして感想をお聞かせください
エンドツーエンド暗号化されたBrave AIチャットは、すべてのチャンネル(Nightly、Beta、Release)で本日から利用できます。BraveのLeoでGLM 5.3 Flashを選択すると、すぐに始められます。
以下のシミュレーションは、実際の体験をイメージしたもので、ライブのチャットではありません。クリックして進めていくと、エンドツーエンド暗号化された会話がどのように流れるかを確認できます。
これまでと同様、フィードバックをお待ちしています。
今後の予定
私たちの目標は、最初の投稿から変わっていません。そのルーツは2014年にまでさかのぼります。プライバシーを信じる必要のないAIアシスタント、つまり自分で検証できるAIアシスタントを実現することです。今後は、次の取り組みを進めていきます。
- ブラウザ内での検証。 アテステーションのチェックをブラウザ自体に移します。あわせてTEEの鍵のログを公開し、すべてのユーザーに同じ鍵が渡されていることを誰でも確認できるようにします。
- モデルの検証。 エンクレーブが、メモリに読み込む正確なウェイトをアテステーションで証明するようにします。量子化版が元のリリースから正しく派生したものであることも検証します。さらに、オープンな学習が検証可能なオープンウェイトモデルを、Brave AIに取り入れていきます。
- 検証可能なプライベートモードで使えるLeoの機能の拡充。 GLM 5.3 Flashは現在ベータ版です。Leoのより多くの機能とオープンウェイトモデルを、検証可能なプライベートチャットに順次対応させていきます。

