
Googleのスクレイピング対策がBraveの問題になった経緯と、ユーザーファーストで解決した方法
近日中に、Brave Searchの検索結果のリンクは、遷移先に直接つながらなくなり、代わりにBraveのURLクローキング方式を経由するようになります。ユーザーから見た動作は何も変わりません。これまでどおり、検索結果をクリックするとページが開きます。その裏で、ブラウザがクローキングを解除し、ユーザーに代わって遷移先へ移動します。
検索エンジンが運営するクローキングサービスは、従来、ユーザーが検索結果ページを離れたあとにどこへ向かうかを把握する手段として使われてきました。私たちは、これまでどおり把握しないままでいたいと考えています。そのために、部分的オブリビアス疑似ランダム関数(partially oblivious pseudorandom function)に基づくプライバシー保護の方式を開発しました。この方式により、Braveはどの検索結果がクリックされたのかを知ることができません。
このサービスが必要になった理由
このクローキング方式を構築した動機は、ボットやスクレイパーへの対策です。きっかけは、Googleが最近導入した類似の仕組みであるGOTOです。GOTOは、検索結果のクリックをgoogle.com/gotoに経由させてから、ユーザーを遷移先ページへ送ります。スクレイパーとは、検索結果を大量に収集し、多くの場合は安価で転売する自動化サービスです。顧客は、自前のインデックスを構築せずに検索データを手に入れたいチャットボットやAIエージェントなどです。多くの取り締まりがそうであるように、Googleの施策はスクレイピング取引をなくしたというより、場所を移したにすぎません。その結果、かつてGoogleに向けられていたスクレイピングの多くがBrave Searchに押し寄せ、もともとあった正規のトラフィックに上乗せされています。しかし、これは私たちが望むトラフィックでも、対応できる余裕があるトラフィックでもありません。
GOTOの導入後、特にリアルタイムで結果を取得する必要がある場合、Googleのスクレイピングは難しくなりました。そこでスクレイパーは、仕入れ先が店を閉めたときに合理的な事業者がとる行動に出ました。別の仕入れ先を探し始めたのです。今回の行き先は、他社の結果を転売する検索エンジンではなく、独自のインデックスを維持している検索エンジンでした。
Brave Searchへの影響は甚大でした。毎秒数千リクエストに達するトラフィックの急増が、サーバーとチームを同じくらい疲弊させています。さらにこのトラフィックのせいで、すでに余裕のないボット対策をより厳しくせざるを得ず、そのしわ寄せは、検索結果の表示速度の低下やCAPTCHAの増加という形で一般ユーザーにかかっています。
私たちはオープンなWebを大切にしています。だからこそBrave Search APIを構築しました。Brave Searchと同じ検索結果を利用でき1、個人や趣味の用途なら無料、商用利用は有料です2。私たちの検索結果が必要な方は、窓から忍び込む人々に頼らず、正面玄関からお使いください。
Googleが動いた理由と、このタイミングの意味
Googleは長年、自社の検索結果を非公式に転売するスクレイパーを、いわば大目に見てきました。それには理由がありました。こうしたスクレイパーはGoogleの競合ではなく、BingやBrave、そして検索事業を立ち上げようとする他のあらゆる事業者の競合だったからです。安価なGoogleの検索結果が安定して供給される状況は、市場の収益化を阻むうえで非常に効率的でした。代替となる検索エンジンを作る経済的な動機が失われるからです。もちろん、検索エンジンの主な収益源は広告です。ただし、広告で収益を上げられるのは、一定の規模(クリティカルマス)に達してからです。それまでの間、収益化のほぼ唯一の代替手段は、検索そのものへのアクセスをAPIとして販売することでした。スクレイパーは、Googleが見て見ぬふりをしているあいだにGoogleの検索結果を転売することで、この手段を使えたのです。確実な事業計画とは言えないものの、手軽だったのは確かです。
この均衡を崩したのが、過去2年間に登場し、定着した、非常に活発な新しい利用者層であるチャットボットとエージェントです。彼らは絶え間なくクエリを送ります。その結果、検索結果の提供は、私たちのような検索エンジンにとっても、Googleの結果を転売するスクレイパーにとっても、その中間にいるあらゆる事業者にとっても、利益の出る事業になりました。「エージェント型」をうたって検索を販売する企業が急増していることが、その証拠です。
この変化によって、ゲームの前提そのものが変わりました。理由は金銭面ではありません(Googleはすでに検索APIの事業から撤退しています)。スクレイパーが、AI分野におけるGoogleの競合にとって欠かせない存在になったからです。Bingの収益化を妨げるだけなら、まだ話は別です。しかし、OpenAIのChatGPT、SpaceXのGrok、Meta、そして人々の注目をめぐってGoogleと真っ向から競うその他すべてのライバルを、間接的に支援することになるとなれば、話はまったく違ってきます。
Braveのクローキングサービスがユーザーに与える影響
検索結果のURLをクローキングすると、いくつかの副作用が生じます(ただし、これらはGoogleが導入したGOTO方式にも共通するものです)。最も目につくのは、検索結果ページからコピーしたリンクが、遷移先ではなくリダイレクト用のURLになることです。リダイレクトURLは有効期限が切れる可能性があるため、ブックマークや長期保存には使わないでください。もう1つの欠点は、リダイレクトがフィッシング攻撃の経路になりうることです。攻撃者がbrave.com/goリンクの信頼性を悪用して、有害なコンテンツを届けるおそれがあります。
私たちは、可能な範囲で対策を講じています。具体的には、リダイレクトを無効化する機能、有効期限(TTL)の設定、ユーザーに注意を促す中間ページの表示です。最後の副作用は、JavaScriptを無効にしているユーザーにのみ当てはまります。この場合、オブリビアス方式は動作しないため、従来型のリダイレクトを行うしかありません。その際は、サーバー(ここではBrave)がクリックされたURLを確認できます。
brave.com/goリンクを使うときの流れ:暗号化とプライバシー
brave.com/goを通じたリンクでは、検索結果のすべてのリンクが暗号化され、正しい鍵がなければ読み取れません。検索結果にカーソルを合わせると、search.brave.com/go/v1#… というアドレスが表示されます。実際の遷移先は末尾の暗号化された部分で、その遷移先情報がBraveのサーバーに送り返されることはありません。リンクごとに固有の鍵があり、それらの鍵を保持しているのはBraveだけです。
例として、「hiking boots」を検索して3番目の結果をクリックするとします。ブラウザは3番目のリンクの鍵を必要とするので、Brave Searchに問い合わせます。ただし、ブラウザは単純に「3番目のリンクの鍵をください」とは伝えません。まず、ブラウザだけが知っている乱数でリクエストを偽装します。どのリンクをクリックしても、Brave Searchに届くリクエストはまったく同じに見えます。
続いてBrave Searchは、偽装されたリクエストに秘密鍵を適用し、その結果を返します。ブラウザは自分の乱数を取り除きます。すると、3番目のリンクの鍵だけが残ります。この鍵は、ほかのリンクには使えません。ブラウザは遷移先を復号し、そのままサイトへ移動します。訪問そのものがBrave Searchを経由することはありません。
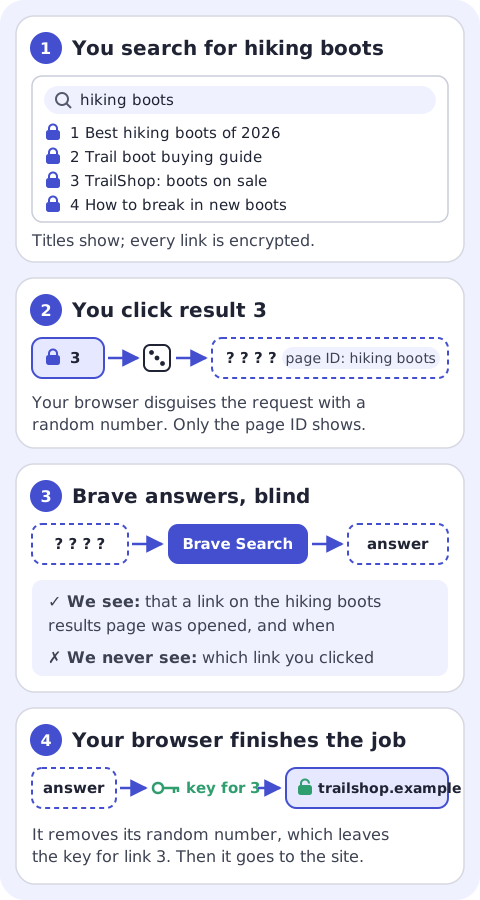
この手法には、部分的オブリビアス疑似ランダム関数(partially oblivious pseudorandom function)という技術を使っています。「オブリビアス(oblivious)」と呼ぶのは、質問の内容を見ずに答えを計算できるからです。また「部分的(partially)」なのは、リクエストの一部(つまり、クリックの元になった検索結果ページ)を、あえて読み取れる状態に残したまま答えを計算するからです。そのため、Brave Searchが把握できるのは、「hiking boots」の検索結果ページからいつ誰かがリンクを開いたか、ということまでです。どのリンクを開いたのかは、決してわかりません。
1つの答えで開けるリンクは1つだけです。ここで、スクレイパーにとっての採算が変わります。人間が検索結果ページから開くリンクは1つか2つです。一方、スクレイパーはすべてのページのすべてのリンクを必要とし、その1つ1つについて鍵を要求しなければなりません。この要求は、ページ単位で数えることができます。これにより、大規模なスクレイピングはコストが高くなります。それでいて、実際に検索する人間の妨げにはならず、人々が具体的にどこをクリックしたかを私たちが知ることもありません。
まとめ
Dijkstraの「GOTOは有害とみなされる」という指摘にならい、私たちはプライバシーを守るGOTOの実装を、スクレイパーにだけ有害なものにしました。ユーザーはこれまでどおり検索結果を利用でき、私たちがユーザーの遷移先を知ることはありません。大規模に検索結果を必要とする方は、ぜひ正面玄関からお越しください。

